1 Introdução à Computação Paralela
Resumo: Neste capítulo são apresentados conceitos, técnicas e mecanismos de suporte do hardware e do Sistema Operacional à Computação Paralela. Falamos um pouco sobre as técnicas de melhorias de desempenho ligadas à arquitetura dos processadores até chegarmos ao multicore. Do suporte do Sistema Operacional à implementação de threads.
1.1 Introdução
As melhorias de desempenho no decorrer das últimas décadas passaram pelo aumento da velocidade de clock, otimizações do conjunto de instruções, hierarquia de memória e níveis de cache e otimizações do código com compilação.
Nos dias atuais, as frentes de pesquisa e desenvolvimento buscam soluções voltadas para a computação sustentável, com técnicas e mecanismos de gerenciamento de energia. Plataformas modernas cada vez heterogêneas, com dispositivos de computação cada vez mais distintos, como Unidades de Processamento Gráfico (GPUs), arranjos de coprocessadores e FPGAS. O que nos leva à Computação Paralela e Heterogênea.
A obtenção de melhorias de desempenho passam atualmente pelo uso de diretivas de compilação, para anotações em código legado e ferramentas como compiladores paralelizantes que com base em diretivas de compilação ou pelo uso de técnicas de paralelização automática, geram versões paralelas dos códigos.
Nesse esforço, fabricantes fornecem bibliotecas otimizadas para suas plataformas ou dispositivos que permitem uma modernização do código, pela substituição de trechos de código legado ou versões ingênuas de algoritmos, por chamadas a versões otimizadas.
1.2 Suporte do Hardware
Tecnologias mais rápidas possibilitam projetos mais eficientes. Partindo-se de um modelo básico de computação foram sendo adicionados aos projetos arquiteturais recursos para a melhoria de desempenho. Entre esses recursos, estão Hierarquia de Memória (Cache) visando mitigar a diferença de tecnologias na construção de CPUs e Memórias. A divisão do ciclo de execução de uma instrução em estágios de um pipeline, que levou a técnicas de previsão de desvios para evitar penalidades de busca de instruções em caminhos errados.
As Arquiteturas Superescalares buscam o Paralelismo em Nível de Instrução (ILP) com escalonamento dinâmico de instruções (Tomasulo 1967) e o mecanismos para a execução fora de ordem. Porém, ainda que processem múltiplas instruções ao mesmo tempo, elas ainda sofrem com ineficiência e subutilização de recursos. O número de instruções executadas por ciclo (IPC) não é muito alto, isto é, hardware fica ocioso.
Para solucionar isso e maximizar o desempenho, surgiu a execução simultânea de diferentes tarefas (como o Simultaneous Multithreading - SMT), uma abordagem que otimiza o uso do processador ao aproveitar tanto o paralelismo das instruções quanto o das próprias tarefas, Paralelismo em Nível de Tarefas (TLP). A execução de múltiplas tarefas diferentes, isto é, aplicações diferentes, garante uma ocupação mais efetiva dos recursos do processador que ficariam ociosos, podem ser utilizados pelas instruções de outras tarefas.
A multiplicidade de núcleos trazida pelos processadores multicore garante um paralelismo em núcleos de processamento diferentes.
1.2.1 Arquiteturas Superescalares
As arquiteturas superescalares expandiram a capacidade em largura através de pipelines distintos para cada unidade funcional, fazendo com que múltiplas instruções sejam buscadas, decodificadas e despachadas para a execução. Mesmo as arquiteturas superescalares, ainda não atingem níveis de paralelismo desejados e acabam sendo subutilizadas ou utilizadas ineficientemente.
Diante da necessidade de melhoria no desempenho e da utilização mais eficiente dos recursos, surgiu a idéia de remessa e execução de instruções de tarefas distintas, caracterizando a execução simultânea de tarefas com o objetivo de intensificar a utilização de recursos e explorar o grau de paralelismo existente entre essas instruções e ainda o grau de paralelismo existente entre tarefas.
O conceito de superescalar é implementado na maioria dos processadores modernos, dando-lhes a capacidade de explorar o paralelismo no nível de instruções (ILP). Em uma arquitetura superescalar típica, o processador busca e decodifica várias instruções tentando garantir um fluxo contínuo de instruções prevendo antecipadamente os resultados de instruções de desvio. As instruções são analisadas e as dependências de dados e de controle são reduzidas, e instruções são despachadas e distribuídas para as estações de reserva associadas e na sequência são emitidas para a execução em suas respectivas unidades funcionais (Smith and Sohi 1995).
A execução em paralelo baseia-se na disponibilidade de operandos ao invés de restringir-se à sequência original do programa, proporcionando um escalonamento dinâmico de instruções, no qual os operandos pendentes em outras instruções são atualizados à medida em que são calculados, permitindo que a execução das instruções que aguardam esses operandos possa então prosseguir. A arquitetura utiliza-se de uma estrutura de reordenação, um buffer ou uma fila, para que após a execução e obtenção dos resultados, o estado do programa seja finalizado na mesma ordem estabelecida pelo código, mantendo assim a semântica do código original.
A execução fora de ordem é obtida sobre as instruções que estão com os operandos prontos, não respeitando a ordem original do código, mas sim o fluxo de dados. Esse paralelismo é implícito no código e ocorre de forma transparente ao usuário, não sendo necessário recompilar as aplicações existentes para a arquitetura alvo.
A execução de instruções em paralelo envolve questões relacionadas à dependência de controle e de dados entre as instruções, ao hardware para suportar a execução de múltiplas instruções em paralelo, às estratégias para determinar quando uma instrução está pronta e à passagem de valores entre instruções que estão em execução.
Instruções de desvio condicional podem levar o fluxo de execução a um caminho tomado pela decisão das técnicas de previsão de desvios, de forma que as instruções executadas desse caminho são executadas em um contexto especulativo, podendo mais tarde serem descartadas ou efetivadas, dependendo da conformidade da previsão. As operações realizadas especulativamente são efetivadas no estado real da máquina somente quando as previsões de desvios são confirmadas. O controle da visibilidade desse novo estado e da manutenção da aparência de execução seqüencial sem prejuízos para a semântica do código original é uma tarefa complexa, exigindo para isso um hardware também complexo.
As técnicas de previsão de desvio tentam prever o caminho a ser seguido pelo fluxo de execução, procurando minimizar os erros de forma que sempre instruções de um caminho correto sejam buscadas, decodificadas e executadas.
1.2.2 Arquiteturas SMT
A denominação Simultaneous Multithreading (SMT) teve origem na publicação de (Tullsen et al. 1995), embora o conceito tenha sido apresentado por idéias semelhantes em trabalhos anteriores como a arquitetura Simultaneous Instruction Issuing (Hirata et al. 1992) e a arquitetura chamada Multistreamed Superscalar (Yamamoto et al. 1994), ambos com a capacidade de executar instruções provenientes de diferentes fluxos simultaneamente.
As arquiteturas SMT têm como objetivo a execução simultânea de tarefas, remetendo à execução instruções de diferentes tarefas durante o mesmo ciclo do processador. Cada tarefa detém, durante a execução, o uso de alguns recursos que constituem o seu contexto de execução, compartilhando diversos outros com outras tarefas em execução. O contexto de cada tarefa é formado pelo conteúdo dos registradores que estão sendo utilizados, pelo seu contador de programa e pelos recursos que estão sob seu domínio.
Através do embaralhamento das instruções das diversas tarefas em execução simultânea, a arquitetura explora o paralelismo em nível de tarefas (TLP), em adição ao ILP, o qual é típico das arquiteturas superescalares convencionais. Esta característica proporciona melhor aproveitamento dos recursos existentes, pois aqueles que estariam ociosos com a execução de uma única tarefa poderão ser aproveitados pela execução simultânea de outras tarefas.
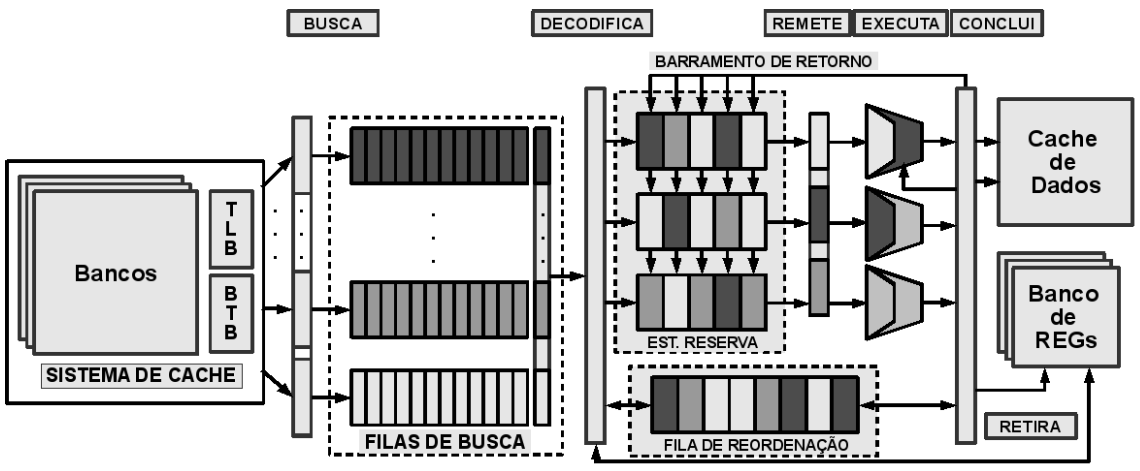
A execução de tarefas simultâneas garante um paralelismo maior em relação à execução convencional, permitindo uma exploração maior dos recursos do hardware. A unidade de busca, entre outros recursos é compartilhada pelas diversas tarefas, permite que as instruções das tarefas sejam buscadas e inseridas no caminho de execução, onde a coexistência de vários contextos permite aproveitar melhor as oportunidades de execução enquanto as tarefas concorrentes alternam seus momentos de cpu-bound e io-bound. A Figura 1.I apresenta o projeto arquitetural de uma arquitetura SMT.
A Figura 1.II apresenta a ideia geral da utilização de recursos na execução em um núcleo SMT, fazendo um comparativo com a utilização dos recursos na execução em um processador de núcleo simples e em um processador de núcleo duplo. Os recursos são representados pelos quadrados, as linhas representam os recursos que podem ser utilizados em paralelo e as colunas mostram a utilização efetiva de cada recurso no decorrer do tempo.
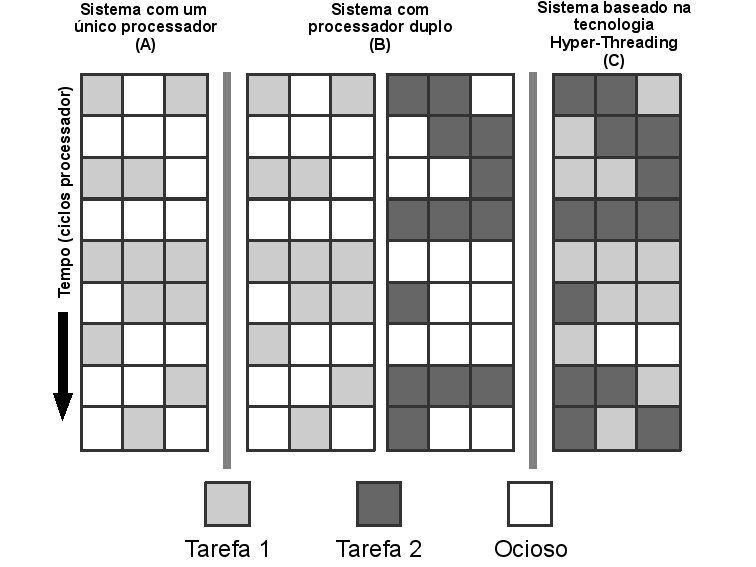
O compartilhamento de recursos e estruturas internas do processador pode ser feito de diversas maneiras e da forma que melhor se adequar ao projeto arquitetural. Por exemplo, a implementação da Intel, denominada tecnologia Hyper-Threading, implementa um pipeline para a execução simultânea de duas tarefas através da duplicação do estado arquitetural, como sendo dois processadores lógicos, porém a execução das instruções é simultânea sobre os recursos compartilhados do mesmo processador físico (Marr et al. 2002), sendo vistos pelo SO como sendo dois processadores físicos.
A tecnologia Hyper-Threading (HT) da Intel (Marr et al. 2002) executa duas tarefas simultaneamente, enquanto que na proposta inicial do conceito SMT (Tullsen et al. 1995) foram realizados experimentos com até 8 tarefas, o que leva a crer que é alta a complexidade envolvida no controle e no compartilhamento de recursos.
A tecnologia HT faz com que um único núcleo físico seja visto como múltiplos núcleos lógicos, pois há uma cópia do estado arquitetural para cada processador lógico que compartilha os mesmos recursos físicos durante a execução. Esses núcleos lógicos são percebidos pelo Sistema Operacional (SO) como se fossem núcleos físicos, podendo escalonar processos ou tarefas para eles como se estivessem em um sistema multiprocessado.
A primeira implementação da HT foi feita para a família de processadores Intel Xeon, com dois processadores lógicos por processador físico. Sua implementação custou menos de 5% no aumento na área do chip e nos requisitos de consumo de potência, fornecendo uma melhoria considerável no desempenho.
O estado arquitetural mantido por cada processador lógico é formado pelos registradores de propósito geral e de controle, por registradores relacionados ao controlador de interrupção e alguns registradores de estado. Todos os outros recursos do núcleo físico são compartilhados, tais como caches, unidades de execução, previsores de desvios, lógica de controle e barramentos.
Cada processador lógico tem seu próprio controlador de interrupção (APIC), favorecendo a idéia de que para o SO é como se fosse um sistema com dois processadores físicos. Assim, interrupções enviadas via software (trap) ou via hardware são tratadas somente pelo processador lógico ao qual são endereçadas.
Um processador lógico pode ter seu funcionamento suspenso temporariamente enquanto falhas na cache e erros de previsão de desvios são tratados ou enquanto aguarda por resultados de instruções executadas anteriormente. Porém, devido ao particionamento dos recursos ser estático, cada tarefa tem seu conjunto particular de recursos. Em um cenário de execução com uma única tarefa, os recursos que seriam compartilhados, provavelmente serão subutilizados momentaneamente, mas este fato não poderá prejudicar as demais tarefas que vierem a ser executadas simultaneamente. Um dos objetivos de SMT é que contextos com uma única tarefa ativa tenham o mesmo desempenho com a tecnologia HT, como teriam em um processador sem essa tecnologia.
1.2.3 Arquiteturas de Múltiplos Núcleos com SMT
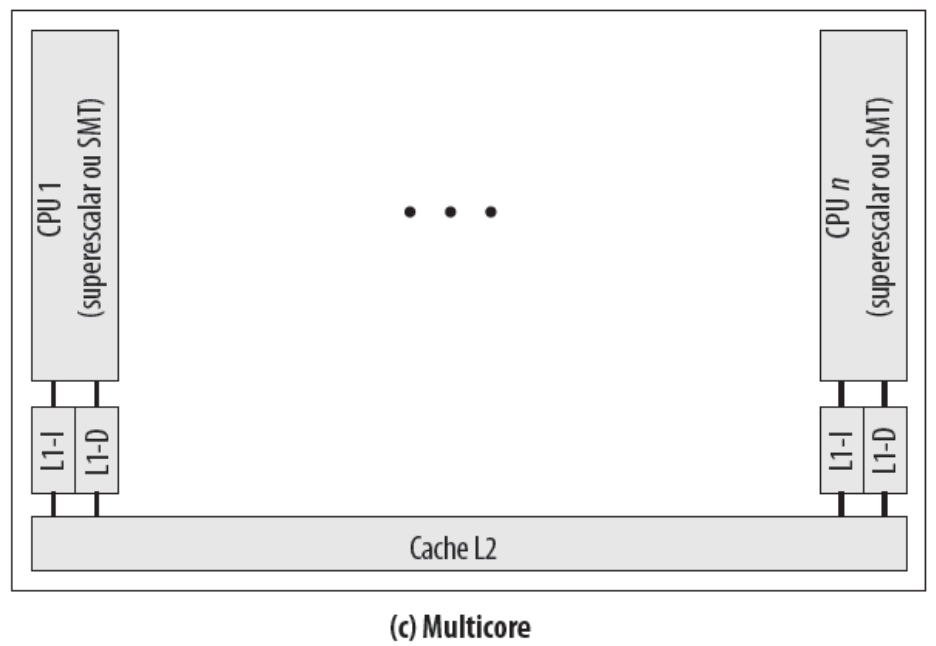
Com o surgimento de arquiteturas de múltiplos núcleos em um único processador físico ou Chip Multiprocessors (CMP) (Olukotun et al. 1996), houve certa redução nas pesquisas em SMT. Entretanto, devido aos limites de desempenho alcançado por esta nova abordagem, o desejo atual é que os processadores passem a combinar as duas estratégias em uma única arquitetura. Com isso, surgem as arquiteturas Chip Multi-Threaded (CMT) (Spracklen and Abraham 2005) como sendo processadores que suportam a execução simultânea de muitas tarefas via combinação do suporte a múltiplos núcleos com SMT. A aplicação de SMT em cada núcleo é feita para os mesmos fins que em processadores de núcleo único, melhor aproveitando os recursos e as oportunidades de execução durante a latência de operações de memória. A Figura 1.III apresenta o diagrama de um processador multinúcleos.
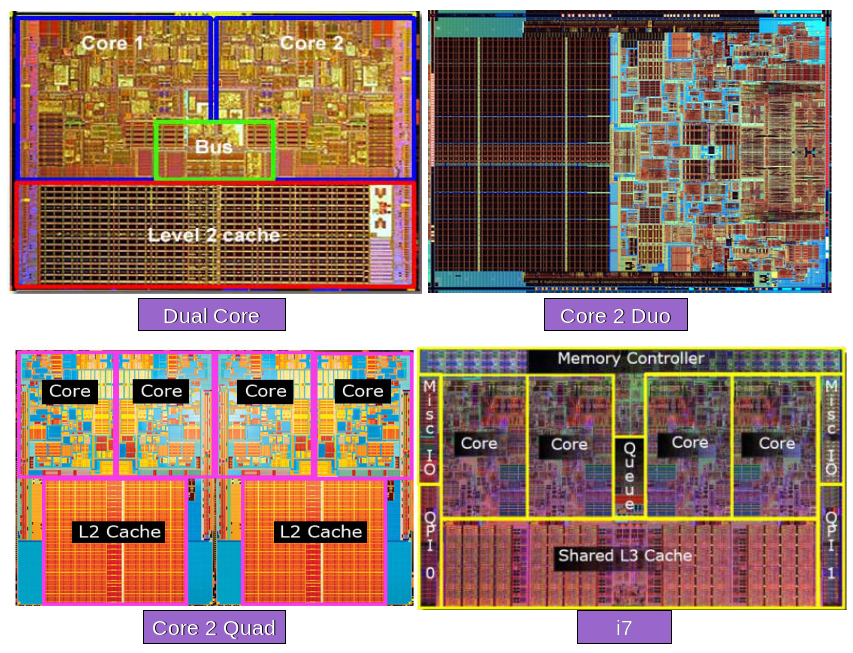
A Figura 1.IV apresenta algumas imagens de chips de processadores que conhecidos.
1.3 Suporte do Sistema Operacional
O Sistema Operacional (SO) é responsável pelo gerenciamento de recursos disponíveis na máquina, gerenciamento e escalonamento dos processos.
Estamos em um ambiente multiprogramado e multiprocessado, mas nem sempre foi assim. Lá no começo, podíamos encontrar a seguinte situação: uma máquina com apenas um processador, com apenas um núcleo, o que conhecemos por single core. Além desses recursos de hardware restrito, se comparado com a situação atual, poderia também ter um Sistema Operacional monoprogramado, isto é, que executa apenas um programa por vez, exemplo, MS-DOS.
Em um ambiente mais comum de hoje, de hardware com múltiplos elementos de processamento, de Sistema Operacional capaz de gerenciar a execução de múltiplos processos, temos a possibilidade de executar diversos aplicações ao mesmo tempo: browser, player de músicas, editor de textos, que antes tinham uma execução intercalada, através do compartilhamento de tempo e de uso de CPU.
Quando executamos um programa qualquer em uma máquina, um processo será criado. Então processos são programas executando em um computador. Cada processo tem um identificador, um pid e vai executar o código associado à sua imagem/segmento de código.
O Código 1.I apresenta um exemplo de código que recupera os identificadores relacionados ao processo.
exemplo-pid-ppid.c
#define _GNU_SOURCE
#include <stdio.h>
#include <unistd.h>
#include <sys/syscall.h>
#include <sys/types.h>
#include <pthread.h>

int main() {
    printf("Main PID: %d, PPID: %d, Main TID: %ld, TID: %ld\n",
           getpid(), getppid(), syscall(SYS_gettid), pthread_self());

    return 0;
}getpid(): Retorna o PID do processo.
getppid(): Retorna o ID do processo pai.
syscall(SYS_gettid): Retorna o ID da Thread (TID) no kernel do Linux, que identifica unicamente uma thread.
pthread_self(): Retorna POSIX thread ID (pthread_t), convertido para unsigned long com (unsigned long)pthread_self().
Todos os processos interagem com o Sistema Operacional por meio de chamadas ao sistema. Quando abrimos um terminal (prompt de comando) e executamos um comando qualquer, como por exemplo, o pwd. O processo do programa terminal é duplicado através da chamada de sistema fork e depois executa uma outra chamada de sistema da família execv para trocar a imagem do código do processo clonado, para que execute o código do programa desejado.
$ pwd
/home/rag
$
A chamada fork cria um processo filho que diferencia-se a partir do processo pai somente em seus PID e PPID. Arquivos abertos, sinais pendentes e todo o espaço de endereçamento do processo pai não são herdados pelo filho. Em caso de sucesso, o PID do processo filho é devolvido para o pai, e um \(0\) é retornado para o filho. Caso contrário, um \(-1\) será retornado no contexto pai, e nenhum processo filho será criado, e um erro será selecionado adequadamente. O Código 1.II apresenta um exemplo do uso da chamada de sistema fork para a criação de um processo.
exemplo-fork.c
#include <stdio.h>
#include <stdlib.h>

int main( ){
    int  pai;
    int  valor = 0;

    pai = fork( );
    if (pai){ /* este trecho é executado pelo pai */
        printf("Eu Sou o Processo Pai %d \n", pai);
        valor = 5;
        printf("Valor: %d \n", valor);
    }
    else { /* este trecho é executado pelo filho */
        printf("Eu Sou o Processo Filho %d \n", pai);
        valor = 10;
        printf("Valor: %d \n", valor);
    }
    exit(0);
}
A família de funções exec substituem a imagem do processo atual por uma imagem de código do novo processo que será executado. O Código 1.III e o Código 1.IV ilustram o funcionamento da chamada exec.
exemplo-exec-comment.c
#include <unistd.h>
#include <stdio.h>

int main() {
   printf("Antes do exec\n");
   // execl("/bin/ls", "/bin/ls", "-r", "-t", "-l", (char *) 0);
   printf("Depois do exec\n");

   return(0);
}
A execução do exemplo do Código 1.II no terminal vai apresentar o resultado que aparece na Figura 1.V.
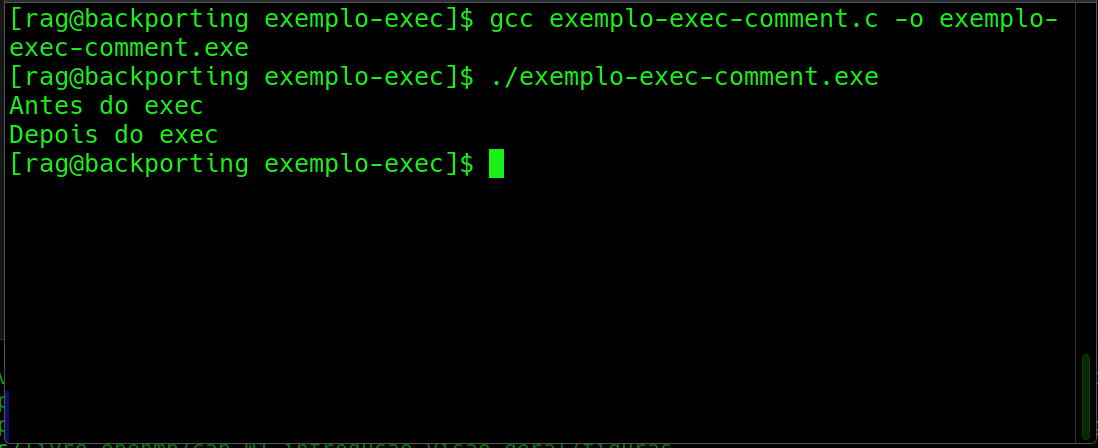
Note que a linha que contém a chamada à função execl(...) está comentada, assim as mensagens “Antes do exec” e “Depois do exec” serão escritas na tela.
Sem o comentário na linha do execl(...) conforme apresentado no Código 1.IV, o que aconteceu? A mensagem “Depois do exec” não foi escrita na tela.
exemplo-exec.c
#include <unistd.h>
#include <stdio.h>

int main() {
   printf("Antes do exec\n");
   execl("/bin/ls", "/bin/ls", "-r", "-t", "-l", (char *) 0);
   printf("Depois do exec\n");

   return(0);
}
A execução exemplo do Código 1.IV no terminal vai apresentar o resultado que aparece na Figura 1.VI.
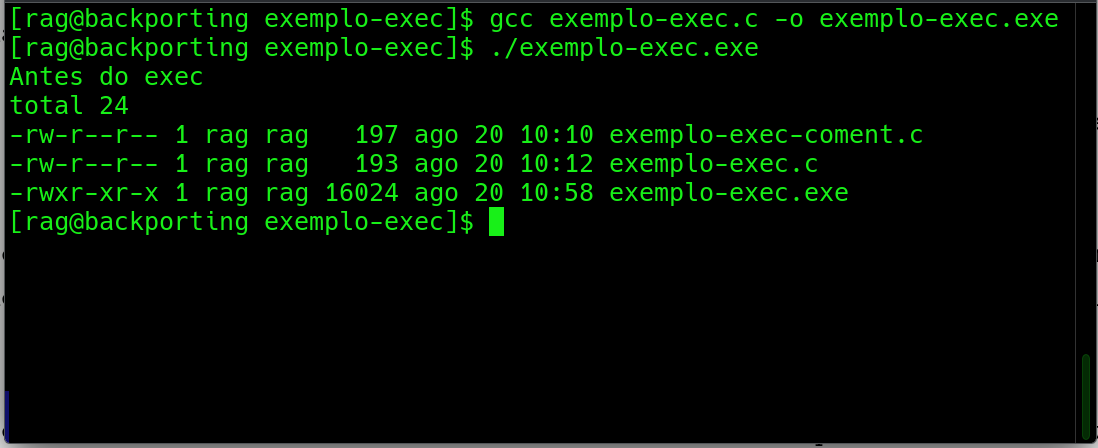
A segunda mensagem não foi escrita, pois no momento que a chamada execl é executada, a imagem de código do processo é trocada pelo código do comando ls, isto é, o código do processo original que imprimia as duas mensagens em torno da chamada execl deixa de existir.
Além da criação de processos, outros recursos podem ser obtidos do gerenciamento feito pelo SO, utilizando chamadas de sistema. Para alocar memória, sua aplicação faz uma chamada à função malloc(...) da biblioteca, que por sua vez faz uma chamada de sistema para alocação de memória no segmento de dados, a heap. Para alocações cotínuas e pequenas a chamada brk / sbrk são utilizadas e deslocam o fim do segmento de dados do processo, já para alocações grandes, a chamada mmap é usada. Essa chamada cria um novo mapeamento de memória virtual independente no espaço de endereçamento do processo. No Linux, o limite padrão para disparar o mmap geralmente é de 128 KB (configurável via M_MMAP_THRESHOLD). As regiões de memória alocadas são liberadas pela chamada à função free().
Vimos que na criação de um novo processo, os processos pai e filho, são uma cópia do código, das variáveis, do espaço de endereçamento do momento da chamada fork. E que a partir da próxima linha cada processo segue um caminho independente. Através do chaveamento feito com o valor da variável pai que recebe o resultado da chamada fork podemos separar o que é executado pelo processo pai e o que será executado pelo filho.
Essa independência dos espaços de endereçamento garante a seguraça do sistema e o isolamento entre os processos.
O que dificulta a execuções para a resolução cooperativa de problemas. Não há compartilhamento natural de dados entre os processos, é necessário utilizar algum mecanismo de comunicação entre processos (IPC – Inter Processs Communication). Os recursos disponíveis que podemos citar são: pipe, fifo, shm, troca de mensagens, sockets cada mecanismo com sua finalidade e suas limitações.
exemplo-shm-client.c
/*
 * Fonte: http://www.cs.cf.ac.uk/Dave/C/node27.html
 */
/*
 * shm-client - client program to demonstrate shared memory.
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/ipc.h>
#include <sys/shm.h>
#include <sys/types.h>

#define SHMSZ (sizeof(tshare))

typedef struct tshare {
  int ii;
  float ff;
  char str[10];
  int alterou;
} tshare;

int main() {
  int shmid;
  key_t key;
  tshare *shm, *s;

  /* É preciso pegar o segmento nomeado como "5678", criado pelo servidor. */
  key = 5678;

  /* Localizando o segmento (locate). */
  if ((shmid = shmget(key, SHMSZ, 0666)) < 0) {
    perror("Erro ao tentar acessar o segmento de shm (shmget).");
    exit(1);
  }

  /* Acoplamento do segmento ao espaço de endereços de dados. */
  if ((shm = shmat(shmid, NULL, 0)) == (void *)-1) {
    perror(
        "Erro ao acoplar o segmento ao espaço de dados do programa (shmat).");
    exit(1);
  }

  /* Lendo o que o servidor colocou na região de memória. */
  s = shm;
  printf("Inteiro: %d\n", s->ii);
  printf("Float: %f\n", s->ff);
  printf("String: %s\n", s->str);
  printf("Alterou: %d\n", s->alterou);

  /* Modificando o primeiro caracter do segmento para '*', indicando que os
   * dados já foram lidos. */
  shm->ii = 10;
  shm->ff = 100.0;
  strncpy(shm->str, "Alterado\0", 9);
  shm->alterou = 1;

  /* Elimina a região de memória compartilhada. */
  if (shmdt(shm) == -1) {
    perror("Erro ao desacoplar a região de memória compartilhada (shmdt).");
    exit(1);
  }

  return EXIT_SUCCESS;
}exemplo-shm-server.c
/*
 * Fonte: http://www.cs.cf.ac.uk/Dave/C/node27.html
 */
#include <errno.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/ipc.h>
#include <sys/shm.h>
#include <sys/types.h>
#include <unistd.h>

/* Tamanho do segmento compartilhado. */
#define SHMSZ (sizeof(tshare))

typedef struct tshare {
  int ii;
  float ff;
  char str[10];
  int alterou;
} tshare;

int main() {

  int shmid;
  key_t key;
  tshare *shm, *s;

  /* Nome do segmento de memória compartilhada "5678". */
  key = 5678;

  /* Cria o segmento compartilhado. */
  if ((shmid = shmget(key, SHMSZ, IPC_CREAT | 0666)) < 0) {
    perror("Erro ao tentar criar o segmento de shm (shmget).");
    exit(1);
  }

  printf("Identificação da região criada: %d. \nPara verificar use:\n ipcs -m "
         "| grep \"%d\"\n",
         shmid, shmid);

  /* Acoplamento do segmento criado ao espaço de dados. */
  if ((shm = shmat(shmid, NULL, 0)) == (void *)-1) {
    perror(
        "Erro ao acoplar o segmento ao espaço de dados do programa (shmat).");
    exit(1);
  }

  /* Colocando dados para o outro processo ler. */
  s = shm;

  tshare *novo = (tshare *)malloc(sizeof(tshare));

  novo->ii = 1;
  novo->ff = 1.0;
  strncpy(novo->str, "abcdefghi\0", 10);
  novo->alterou = 0;

  memcpy(s, novo, sizeof(tshare));

  /* Aguardando a leitura do outro processo. O client irá mudar o primeiro
   * caractere da região compartilhada para '*', indicando que já fez a leitura
   * do que foi posto lá.
   */
  while (shm->alterou != 1)
    sleep(1);

  printf("Inteiro: %d\n", shm->ii);
  printf("Float: %f\n", shm->ff);
  printf("String: %s\n", shm->str);
  printf("Alterou: %d\n", shm->alterou);

  /* Desacoplamento da região de memória compartilhada. */
  if (shmdt(shm) == -1) {
    perror("Erro ao desacoplar a região de memória compartilhada (shmdt).");
    exit(1);
  }
  /* Destruição do segmento */
  if (shmctl(shmid, IPC_RMID, NULL) == -1) {
    perror("Erro ao destruir o segmento compartilhado. (shmctl).");
    exit(1);
  }

  return EXIT_SUCCESS;
}
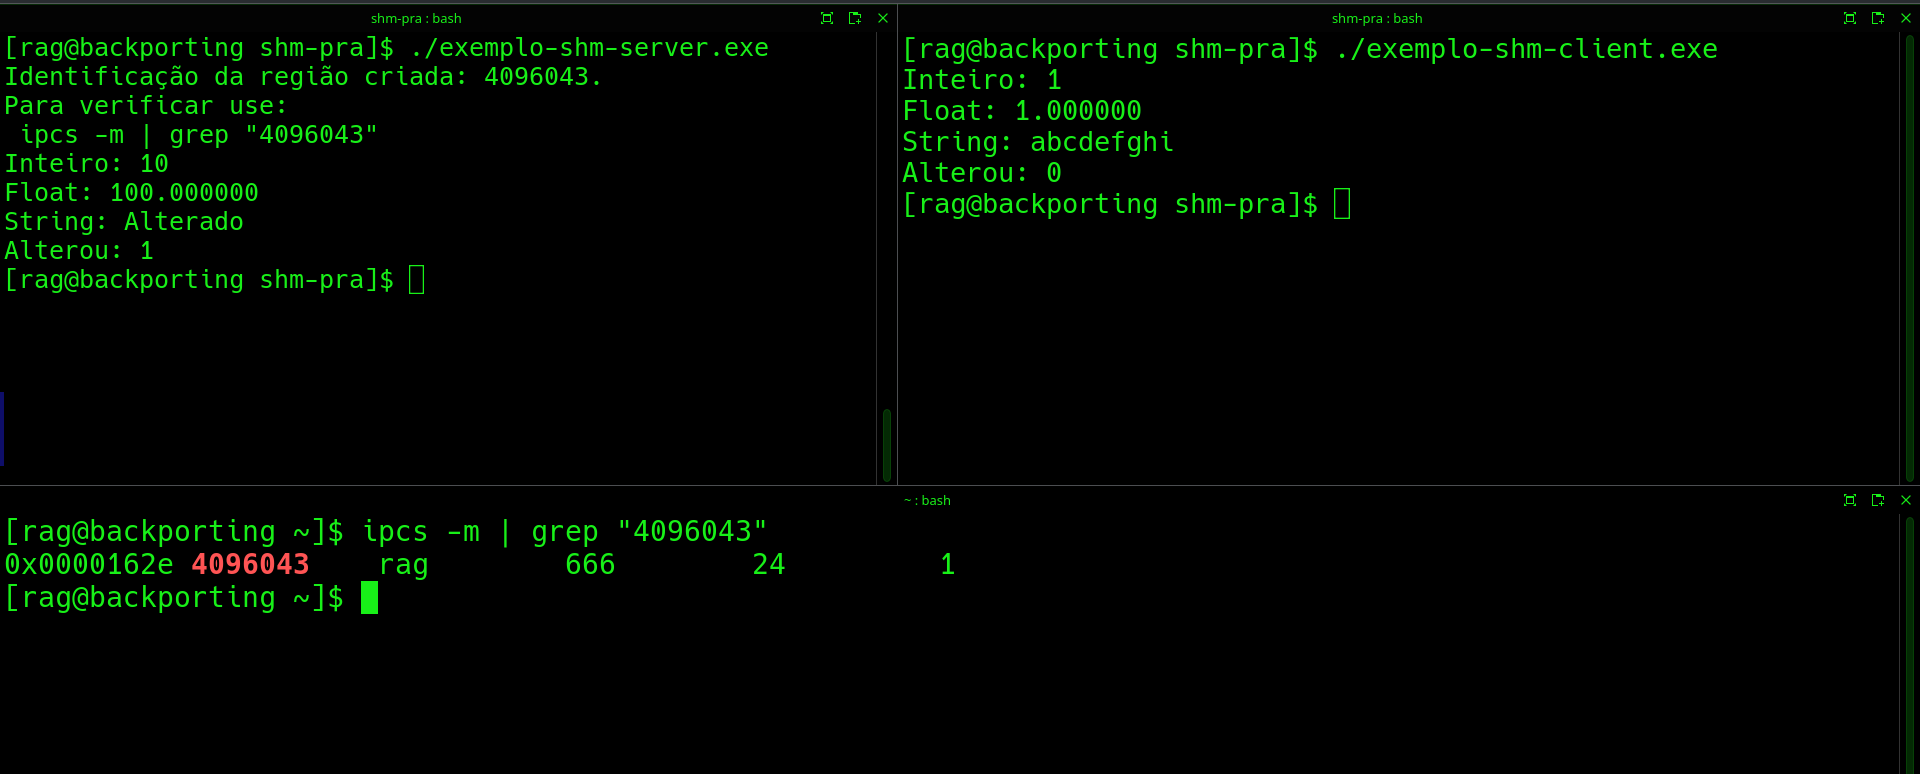
A Figura 1.VII apresenta o resultado da execução do exemplo de compartilhamento de memória.
No arquivo <sys/shm.h> não tem limite fixo do tamanho dos dados que podem ser compartilhados. O limite máximo depende dos parâmetros do kernel (como SHMMAX e SHMALL no Linux) e da arquitetura do processador (32 ou 64 bits), podendo alcançar gigabytes ou frações significativas da memória RAM física e virtual disponíveis.
O SHMMAX (/proc/sys/kernel/shmmax) define o tamanho máximo (em bytes) permitido para um único segmento de memória compartilhada. Em sistemas modernos de 64 bits, o padrão costuma ser muito grande (próximo ao limite de um unsigned long). E o SHMALL (/proc/sys/kernel/shmall) é o limite total de páginas de memória compartilhada que podem ser alocadas simultaneamente no sistema inteiro. Para verificar qual o valor desse parâmetro basta executar os comandos:
$ cat /proc/sys/kernel/shmmax
18446744073692774399
$ cat /proc/sys/kernel/shmall
18446744073692774399

$ sysctl kernel.shmmax
kernel.shmmax = 18446744073692774399

$ sysctl kernel.shmall
kernel.shmall = 18446744073692774399
Em sistemas de \(32\) bits, o espaço de endereçamento por processo restringe o tamanho prático de um segmento a menos de 4 GB, enquanto sistemas de 64 bits suportam segmentos massivos limitados apenas pela RAM e swap. Caso seja necessário alterar esses limites ou verificar a configuração atual no seu sistema, o conteúdo do arquivo /proc/sys/kernel/shmmax pode ser alterado temporariamente pelo comando:
sudo sysctl -w kernel.shmmax=VALOROu pode editar diretamente o arquivo /etc/sysctl.conf incluindo no final ou alterando valores existentes para
as variáveis kernel.shmmax = VALOR_EM_BYTES e kernel.shmall = VALOR_EM_PAGINAS. Para aplicar as mudanças sem a necessidade de reiniciar a máquina, o comando sudo sysctl -p pode ser executado.
1.4 Prática
- Com base nos exemplos de
forke memória compartilhadashmaltere o código do exemplovectoraddpara que soma de vetores seja feita por mais processos.
1.5 Considerações Finais
Neste Capítulo revisamos conceitos sobre suporte do hardware e do Sistema Operacional ao paralelismo. A criação de múltiplos processos e os mecanismos de comunicação entre processos. Em específico o compartilhamento de memória entre os processos independentes para a resolução de problemas cooperativos.
1.6 Word Cloud